Yapay zeka modellerinin eğitiminde kullanılan veri setleri, özellikle görüntü, video ve büyük dil modeli eğitim korpüsleri söz konusu olduğunda terabaytlarla, hatta petabaytlarla ifade edilen boyutlara ulaşabiliyor. Bu ölçekte veri biriktiren kişi ve kuruluşlar için depolama stratejisi, sadece “yeterince büyük bir disk almak”tan çok daha fazlasını gerektirir. Bu yazıda harddisklerin bu tür iş yüklerindeki rolünü ele alıyoruz.
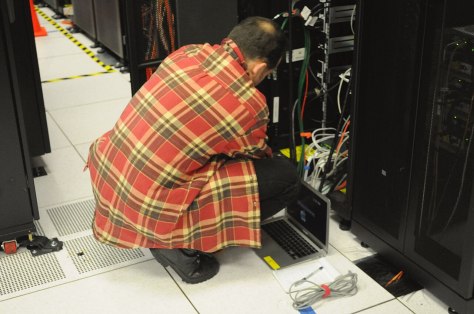
Görsel: Bir veri merkezinde sunucu rack’i üzerinde çalışan bir teknisyen — büyük ölçekli veri projeleri bu tür altyapılara dayanır. Fotoğraf: Derrick Coetzee, Wikimedia Commons, CC0 (kamu malı).
Neden Hâlâ Harddisk?
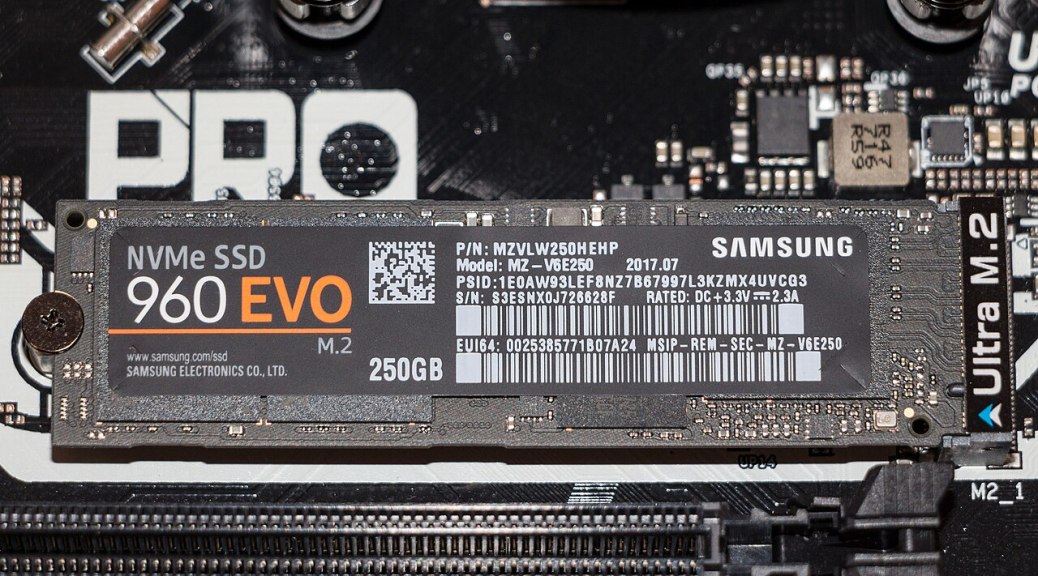
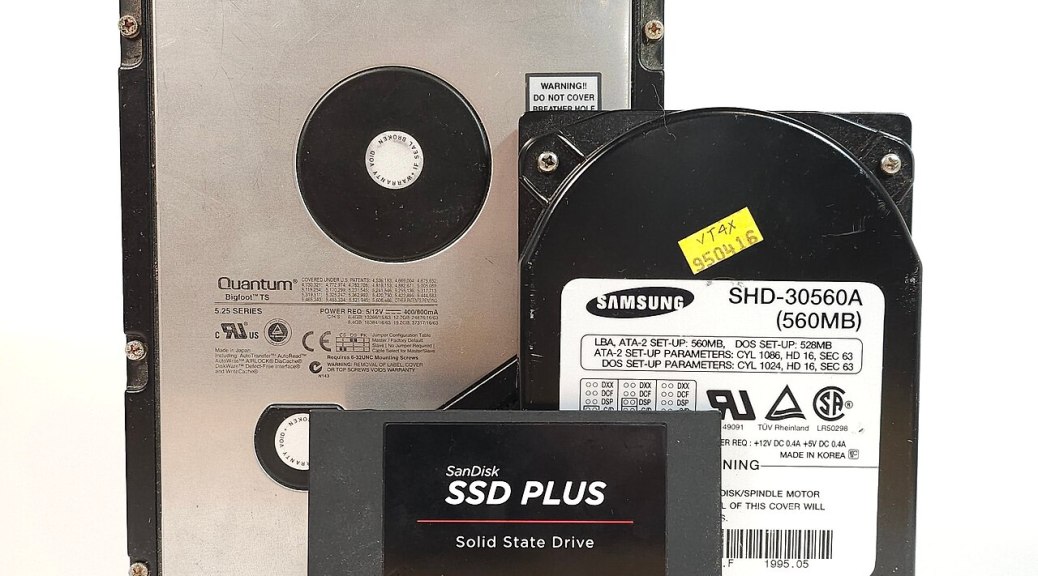
SSD’ler yüksek hız sunsa da, gigabayt başına maliyet açısından harddiskler hâlâ büyük ölçekli, “soğuk” veya yarı-soğuk veri depolama için önemli ölçüde daha ekonomiktir. Bir yapay zeka projesinde ham veri seti genellikle bir kez toplanır, ön işlemeden geçirilir ve eğitim sürecinde tekrar tekrar okunur; ancak bu okuma paterni çoğunlukla sıralı (sequential) niteliktedir — rastgele küçük dosyalara anlık erişim yerine, büyük veri bloklarının art arda okunması söz konusudur. Harddiskler, tam olarak bu tür sıralı okuma/yazma senaryolarında SSD’ye kıyasla çok daha az performans farkıyla, ciddi bir maliyet avantajı sunar.
Katmanlı (Tiered) Depolama Yaklaşımı
Ciddi ölçekli veri bilimi ortamlarında yaygın uygulama, depolamayı katmanlara ayırmaktır: aktif olarak eğitimde kullanılan, sık erişilen veri parçaları hızlı SSD katmanına yerleştirilir; henüz işlenmemiş ham veri veya eğitimi tamamlanmış modellerin ürettiği büyük çıktı/log dosyaları ise daha ucuz, yüksek kapasiteli harddisk katmanında tutulur. Bu yaklaşım, toplam depolama maliyetini makul seviyede tutarken performanstan önemli ölçüde ödün vermemeyi sağlar.
Bu katmanlar arasında veri taşıma işlemini otomatikleştiren yazılım çözümleri, hangi verinin ne sıklıkta erişildiğini takip ederek sık kullanılmayan verileri otomatik olarak daha ucuz katmana taşır. Küçük ölçekli bir kişisel proje için bu derece otomasyon gerekmese de, büyüyen bir veri seti söz konusu olduğunda bu tür bir sistemin baştan planlanması, ileride manuel veri taşıma yükünü önemli ölçüde azaltır.
Yedekleme ve Veri Bütünlüğü Kritik Önem Taşır
Aylarca süren bir veri toplama veya etiketleme (labeling) sürecinin sonunda ortaya çıkan bir veri setinin kaybolması, sadece depolama maliyeti değil, geri alınamaz zaman kaybı anlamına gelir. Bu nedenle büyük veri setleriyle çalışan ekiplerin, RAID yapılandırmaları ve düzenli, site dışı yedekleme stratejileri (3-2-1 kuralı gibi) uygulaması kritik önem taşır. Tek bir diskte tutulan, yedeksiz bir veri seti, projenin en zayıf halkası olabilir.
Çoklu Disk Yoğunluğu ve Fiziksel Planlama
Büyük veri setlerini barındıran yerel sunucular veya iş istasyonları genellikle çok diskli yapılandırmalar (multi-bay NAS, RAID kabinleri) kullanır. Bu tür yoğun disk ortamlarında, diskler arası titreşim, soğutma ve güç dağıtımı gibi fiziksel faktörler de performans ve güvenilirlik üzerinde doğrudan etkilidir; bu nedenle bu tür kurulan sistemlerde kurumsal sınıf, titreşime dayanıklı disklerin tercih edilmesi genellikle önerilir.
Soğuk Depolama ve Veri Seti Sürümleme
Yapay zeka projelerinde veri setleri genellikle zaman içinde güncellenir, temizlenir veya genişletilir; bu da farklı sürümlerin (versiyonların) saklanması ihtiyacını doğurur. Her sürümü aktif, hızlı erişilebilir depolamada tutmak hem gereksiz maliyetli hem de genellikle gereksizdir — çünkü modelin belirli bir sürümü eğitildikten sonra, o veri seti sürümüne nadiren geri dönülür. Bu tür “soğuk” sürümler, yüksek kapasiteli, nispeten yavaş ama ekonomik harddisk tabanlı arşiv katmanlarında saklanabilir; ihtiyaç halinde geri çağrılabilir olması yeterlidir, sürekli hızlı erişim gerekmez. Bu yaklaşım, projenin tüm geçmişini kaybetmeden depolama bütçesini disiplinli tutmanın pratik bir yoludur.
Sonuç olarak, yapay zeka ve büyük veri projelerinde harddiskler hâlâ vazgeçilmez bir rol oynuyor — özellikle maliyet-etkin, büyük hacimli, sıralı erişimli veri depolama ihtiyacı söz konusu olduğunda. Doğru strateji, SSD ve HDD’yi rakip değil, birbirini tamamlayan iki katman olarak konumlandırmaktan geçiyor.